Claude Fable 5.2 要不要換?價錢是 Opus 5.5 兩倍,難題卻花得比較少
Fable 5.2 要不要換?平常的工作繼續用 Opus 5.5;Opus 開到最高檔還很吃力的難題,才值得換 Fable。它的價錢是 Opus 5.5 的兩倍,但 Anthropic 自己的測試裡,它不用開到最高 effort 就追平 Opus 的最高分,難題每題花費約一半,有的不到十分之一。這篇整理比較數據、Pro 免費試用期限、被擋下時換成 Opus 的開關,以及 API 換模型的檢查清單。
Claude 這週推出新模型 Fable 5.2。先講結論:平常的工作不用換,繼續用 Opus 5.5;手上有 Opus 開到最高檔還做得很吃力的難題,才值得換 Fable。 如果你用的是 Pro 方案,到台灣時間 11/17(二)15:59 前用 Fable 不用另外付錢,剛好可以拿一件最難的工作試。
會這樣建議,是因為 Fable 5.2 的價錢是 Opus 5.5 的兩倍,但它不用開到最高 effort,就追平 Opus 開到最高的分數。Anthropic 自己的測試裡,在專家等級的學科考題 Humanity's Last Exam(HLE),Fable 開最低檔就追平 Opus 的最高分,每題花費不到十分之一;在寫程式的 FrontierCode 2.0,Fable 開 high 拿 45.3%,Opus 開到 max 是 45.5%,Fable 每題花費大約一半。所以最難的題目交給 Fable,做完一題的錢比較少。平常的工作,Anthropic 自己也建議先用 Opus 5.5。
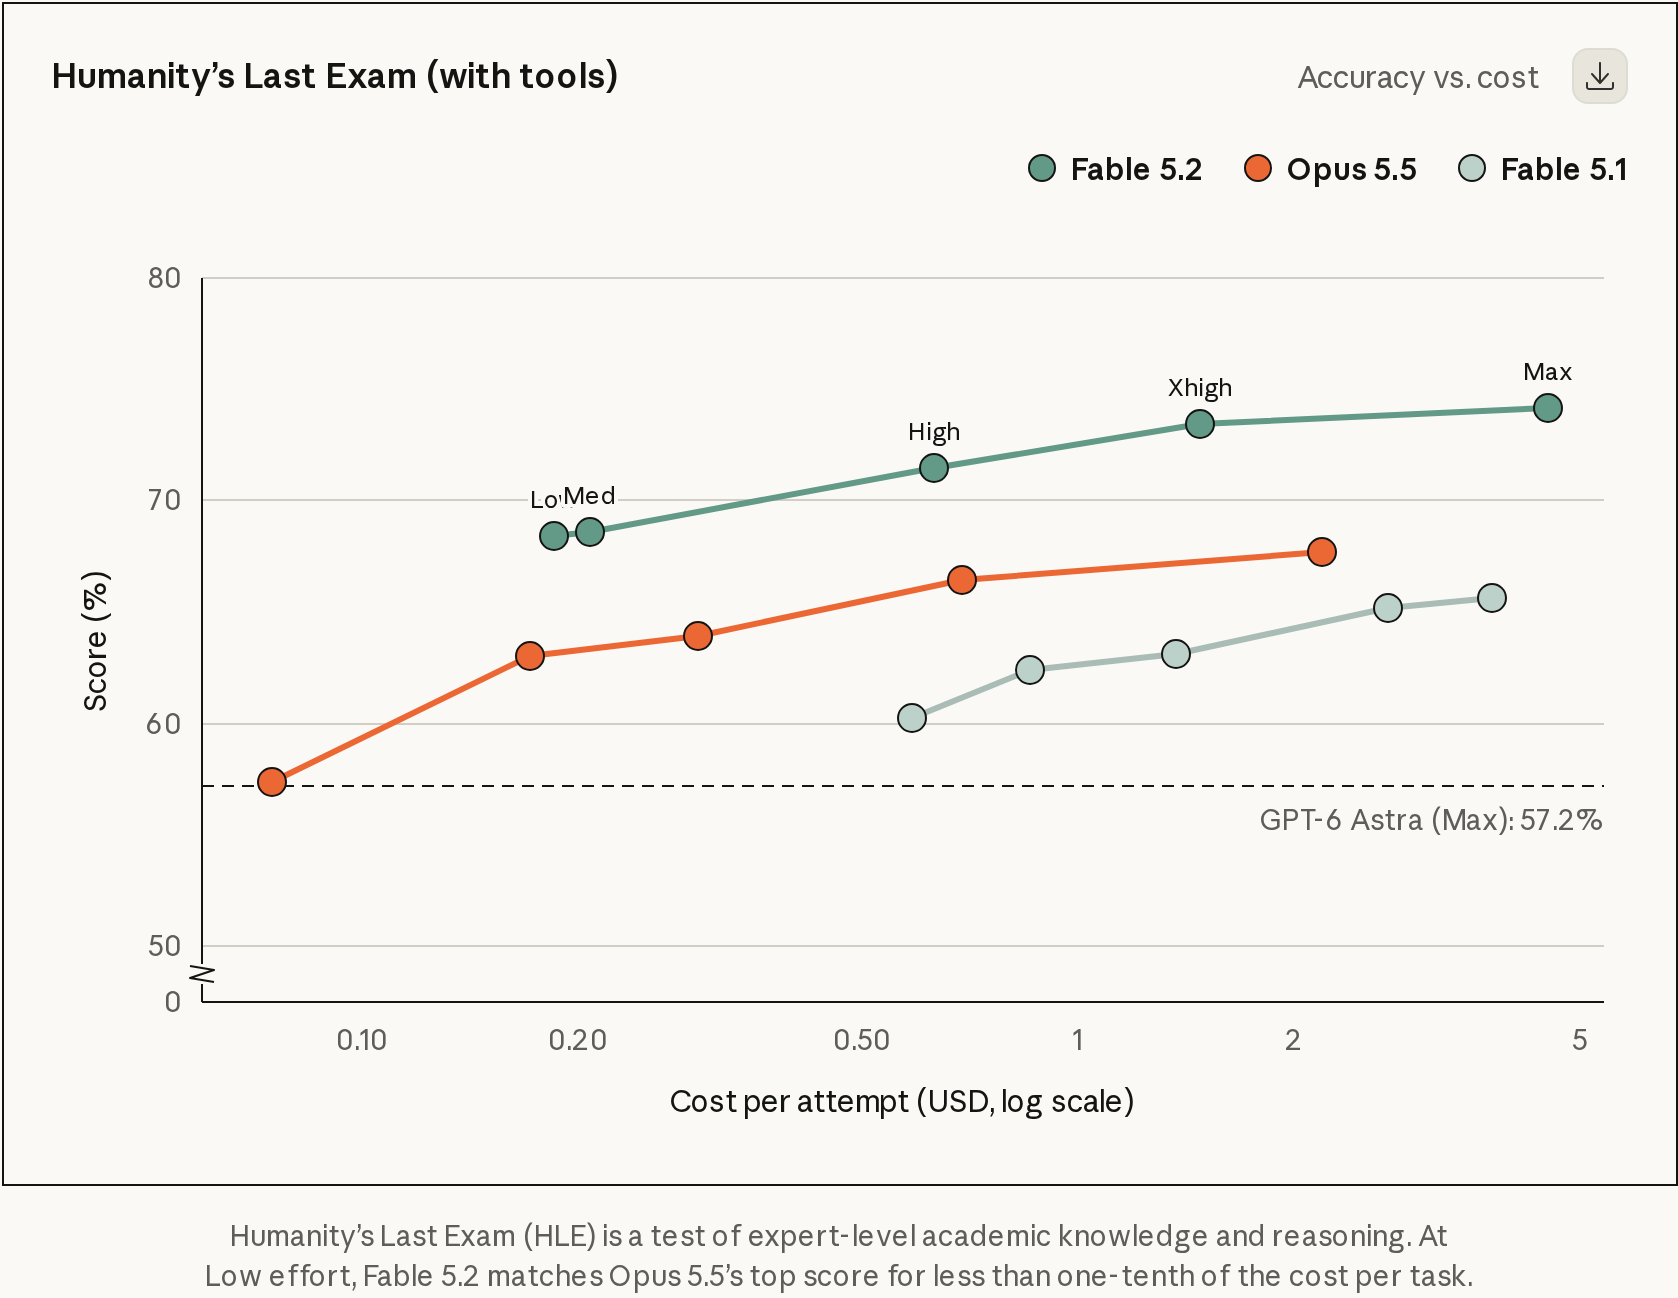
Anthropic 發表文的 HLE 圖。橫軸是每題花費(對數刻度,越右越貴),縱軸是分數。綠線 Fable 5.2 最左邊那點是 Low effort,已經跟橘線 Opus 5.5 最右邊的最高分差不多高。
本文重點
- 價錢:API 每百萬 token 輸入 8 美元、輸出 40 美元,是 Opus 5.5 的兩倍。
- 難題比較省:Fable 開比較低的 effort 就追平 Opus 開到最高的分數,HLE 每題花費不到十分之一,FrontierCode 約一半。這些是 Anthropic 自己的測試。
- 平常照用 Opus 5.5:Anthropic 的原文建議是大多數寫程式和知識工作先用 Opus 5.5,需要時再往上換 Fable。
- Pro 這週免費試:到台灣 11/17(二)15:59 前,Fable 最多用掉每週上限的一半,不用另外付錢,要自己在模型選單選 Fable 5.2。
- 也有輸的:模擬公司日常流程的 AutomationBench,Gemini 4 Carbon 53.9% 贏 Fable 的 51.4%。第三方評測截至 11/10 還沒出來。
- 問到資安或生物會換人回答:Fable 和 Mythos 是同一個模型,請求被擋下時改由 Opus 4.8 或 Opus 5 回答,開關在設定裡。
一張表看你要不要換
| 你是 | 建議 |
|---|---|
| Pro 或 Team 標準席位 | 這週到台灣 11/17(二)15:59 前免費試。挑一件用 Opus 5.5 要來回很多輪、或做到一半就卡住的長任務,同一件事兩邊比。之後 Fable 要用 usage credits 另外付費,你已經有自己的比較結果可以判斷值不值得 |
| Max 或 Ultra | 本來就能用,這次多拿 1 到 3 次額度重置,台灣 2027/3/9(二)15:59 前有效。平常留在 Opus 5.5,要跑很久、很開放的技術工作再切 Fable |
| 用 API 做產品 | 先別直接換掉正式環境的模型。照文末清單確認資料保留和 rate limit,用自己的評測比「每題花費」和品質 |
| 工作跟資安或生醫有關 | Fable 很可能常把你的請求轉給 Opus 4.8 或 Opus 5,官方也寫目前不建議把 Fable 用在專業生物研究和藥物開發 |
| 日常聊天、寫文件、改短程式 | 繼續用 Opus 5.5 就好,這正是 Anthropic 建議先用 Opus 的範圍 |
貴兩倍,為什麼難題比較省
重點在一個數字:你付的錢是單價乘上用掉的 token。同一題,模型想多久、呼叫幾次工具、來回幾輪,token 可以差好幾倍。Fable 不用想那麼久就做到同樣的分數,總花費就可能比單價便宜一半的 Opus 還少。就像請一個時薪貴一倍的老師傅,難的活他很快做完,算下來工錢比較少。
先看單價
Anthropic 價目表上的數字,單位是美元,每百萬 token:
| 項目 | Fable 5.2 | Opus 5.5 | Fable 5.1 |
|---|---|---|---|
| 輸入/輸出 | 8/40 | 4/20 | 10/50 |
| 快取讀取 | 0.20 | 0.20 | 0.25 |
| Batch 輸入/輸出 | 4/20 | 2/10 | 5/25 |
| Fast mode 輸入/輸出 | 16/80 | 8/40 | 價目表未列 |
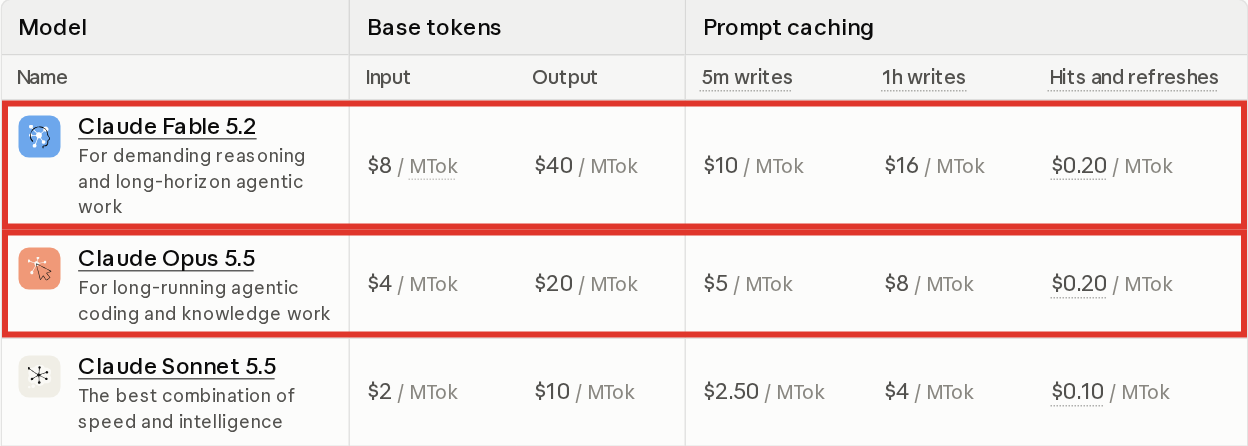
Anthropic 價目表(platform.claude.com/docs/en/about-claude/pricing)。
Fable 5.2 比上一代 Fable 5.1 便宜 20%,輸出速度最多快 30%。有一格兩者一樣:快取讀取都是 0.20 美元。長對話裡命中快取的那部分,Fable 5.2 沒有比較貴。
再看做完一題花多少
Anthropic 在發表文附了幾張「分數對每題花費」的圖,圖說裡的數字如下,全部是 Anthropic 自己的測試:
- Humanity's Last Exam(專家等級的學術知識與推理):Fable 5.2 開 Low 就追平 Opus 5.5 的最高分,每題花費不到十分之一。
- Chartography(看懂圖表):Fable 5.2 開 Medium 拿 66.4%,高過 Opus 5.5 開 Max 的 64.4%,每題花費不到十分之一。
- WANDR(大量資料蒐集任務):Fable 5.2 開 Medium 就追平 Opus 5.5 的最高分,每題花費約四成。
- FrontierCode 2.0(改的程式碼會不會被開源專案維護者合併):Fable 5.2 開 High 拿 45.3%,Opus 5.5 最好是 45.5%,每題花費約一半。
這些是特定測驗的結果,不保證你每一種工作都會比較省。官方文件也建議開發者用自己的評測重新試一輪 effort,不要直接沿用在 Opus 5.5 上調好的設定。
一句話記住:單價和每題花費
Fable 5.2 每 token 單價是 Opus 5.5 的兩倍,但 Anthropic 自己的測試裡,它不用開到最高 effort 就追平 Opus 5.5 的最高分:HLE 開 Low 每題花費不到十分之一,FrontierCode 開 High 約一半。比模型要比做完一題花多少,不是比單價。
Effort 就是「要它想多認真」
Effort 控制模型想多深,Fable 5.2 分五檔:low、medium、high、xhigh、max。開越高想越久,token 也用越多。官方〈Prompting Claude Fable 5.2〉的建議:
| Effort | 官方建議用在 |
|---|---|
| low | 快速來回、需求寫得很清楚、大量處理的工作;官方說 Fable 5.2 在 low 的分數接近 Fable 5.1 開較高 effort 的分數 |
| medium | 互動式寫程式、聊天、日常知識工作 |
| high | 困難的程式、研究、agent 工作、長時間沒人看著的任務;每一輪明顯比 medium 久 |
| xhigh | 最難的長時間程式與 agent 工作,而且你量過確實有提升 |
| max | 量模型的天花板,或少數不在乎時間和 token 的任務,例如科學發現和數學 |
預設值最容易搞錯:
- Claude App 和 Claude Code 預設 Medium。發表文原話:「On Medium effort (the default in Claude apps and Claude Code)」。
- API 預設 high,Opus 5.5 的 API 預設是 medium。程式裡沒指定 effort、只換模型 ID 的話,會自動高一級。請求一樣會成功,只會反映在花費、速度和結果上,從錯誤訊息看不出來。
另外三個官方寫出來的行為:
- 在 high 以上,模型幾乎每一則回覆前都會先思考,連回一句打招呼也是。
- prompt 裡寫「直接回答、不要多想」,在 medium 以上擋不住它思考。想省 token 要調低 effort。
- Effort 幾乎不影響回覆長短。要控制長度和語氣,寫在 prompt 裡。
誰能用、要不要另外付錢
所有付費方案都選得到 Fable 5.2,Free 不能用。差別在於用 Fable 的時候扣的是誰的錢:Pro 平常要另外付,Max 本來就含。
| 方案 | 平常怎麼算 | 這次上市優惠 |
|---|---|---|
| Free | 不能用 | 不適用 |
| Pro、Team 標準席位 | 不含在方案額度裡,從第一則訊息就用 usage credits 按量付費 | 到台灣 11/17(二)15:59 前,Fable 最多用到每週額度的 50%,外加 1 次 Fable 額度重置 |
| Max、Ultra、Team 進階席位、席位制 Enterprise 進階席位 | 含在方案裡,最多用到每週額度的 50%;用完可以改扣 usage credits,或換回其他模型 | 依訂閱時間給 1 到 3 次 Fable 額度重置,台灣 2027/3/9(二)15:59 到期 |
| 席位制 Enterprise 標準席位 | 不含在方案額度裡,組織有開 usage credits 才能用 | 不適用 |
| 用量計費的 Enterprise、Claude API | 照 API 牌價計費 | 不適用 |
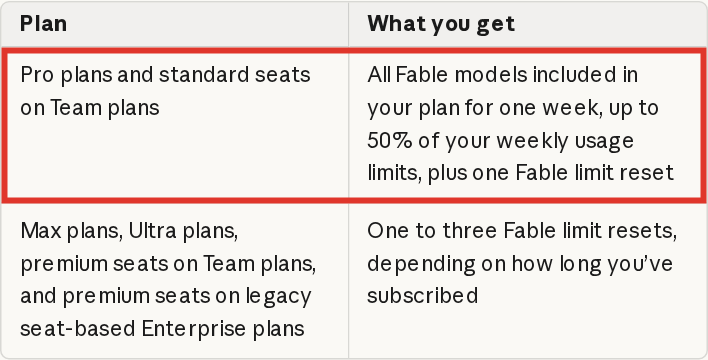
Anthropic 說明頁〈Claude Fable 5.2 launch offers〉的方案對照表,紅框為 Pro 與 Team 標準席位。
「每週額度的 50%」不是多送一半
Fable 和其他模型扣的是同一個每週額度,Fable 最多只能占一半,加起來不會超過每週上限。官方 FAQ 特別回答過這題。Fable 消耗額度也比其他 Claude 模型快,用量可以在 Settings > Usage 隨時看。
Pro 這週要注意的四件事
- 預設模型不會自己換。要從模型選單選 Fable 5.2。
- 期限是台灣 11/17(二)15:59,官方寫的是美西 11/16 23:59。50% 用完或一週結束後,有開 usage credits 的話會改扣 credits。
- 沒用完不會累積。這週的 50% 不會留到下週,那 1 次重置沒用也會同時過期。
- 重置有資格門檻。帳號要在台灣 11/10 02:00 前已經是付費狀態;當時還在免費試用的,轉成付費後才會拿到。
那一次重置,留到撞上五小時上限再按
到 Settings > Usage,在 Limit resets 底下按「Reset for free」,Fable 的額度會馬上恢復,到期前隨時能按。
重置會做兩件事。第一,把每週額度裡花在 Fable 的部分還給你,其他模型的部分不動。官方的例子:每週額度用了 80%,其中 50% 是 Fable、30% 是其他模型,按下去會回到 30%。第二,如果你的帳號有五小時額度,整個五小時視窗會補滿,連其他模型用掉的也一起補回來。所以只有一次重置的話,留到撞上五小時上限再按最划算。
其他產品的版本要求
- Claude Code 要 2.1.321 以上才看得到 Fable 5.2。
- Cowork 要更新到最新版 Claude Desktop。
- Enterprise 預設關閉,要管理員打開。發表七天後,Fable 5.2 會自動加進所有已開任一 Fable 模型的角色,原本預設 Fable 的也會改成 Fable 5.2,除非管理員事先退出。
強在哪、輸在哪
Fable 5.2 在大部分項目贏 Opus 5.5,但不是每一項,而且全部是 Anthropic 自己測的。Anthropic 的用詞是「almost all」:幾乎所有評估的能力都比 Opus 5.5 高一階。
表格附註寫:Fable 5.2、Fable 5.1 和 Opus 5.5 都開著安全把關跑;除非另外註明,都是各模型最高的 effort。
| 測驗(官方分類) | Fable 5.2 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|
| FrontierCode 2.0(agent 寫程式) | 49.1%(Xhigh) | 45.5% | 42.8% | 41.1%(Medium) |
| FrontierSWE v2(agent 寫程式) | 69.9% | 62.3% | 65.5% | 61.2% |
| AutomationBench(商務流程) | 51.4% | 42.5% | 41.4% | 53.9% |
| WANDR(agent 搜尋) | 82.1% | 72.3% | 未列 | 未列 |
| OSWorld 2.1(操作電腦) | 89.3% | 87.2% | 79.5% | 81.5% |
| AA-Briefcase v1.1 rubric(知識工作) | 66.1% | 61.2% | 52.0% | 61.8% |
| AA-Briefcase v1.1 Elo(知識工作) | 1785 | 1800 | 1569 | 1611 |
| Remote Labor Index(知識工作) | 41.3%(High) | 21.3% | 20.8% | 未列 |
| Humanity's Last Exam(含工具) | 74.2% | 67.7% | 57.2% | 未列 |
| Chartography(看圖表,不用工具) | 73.4% | 64.4% | 71.0% | 72.5% |
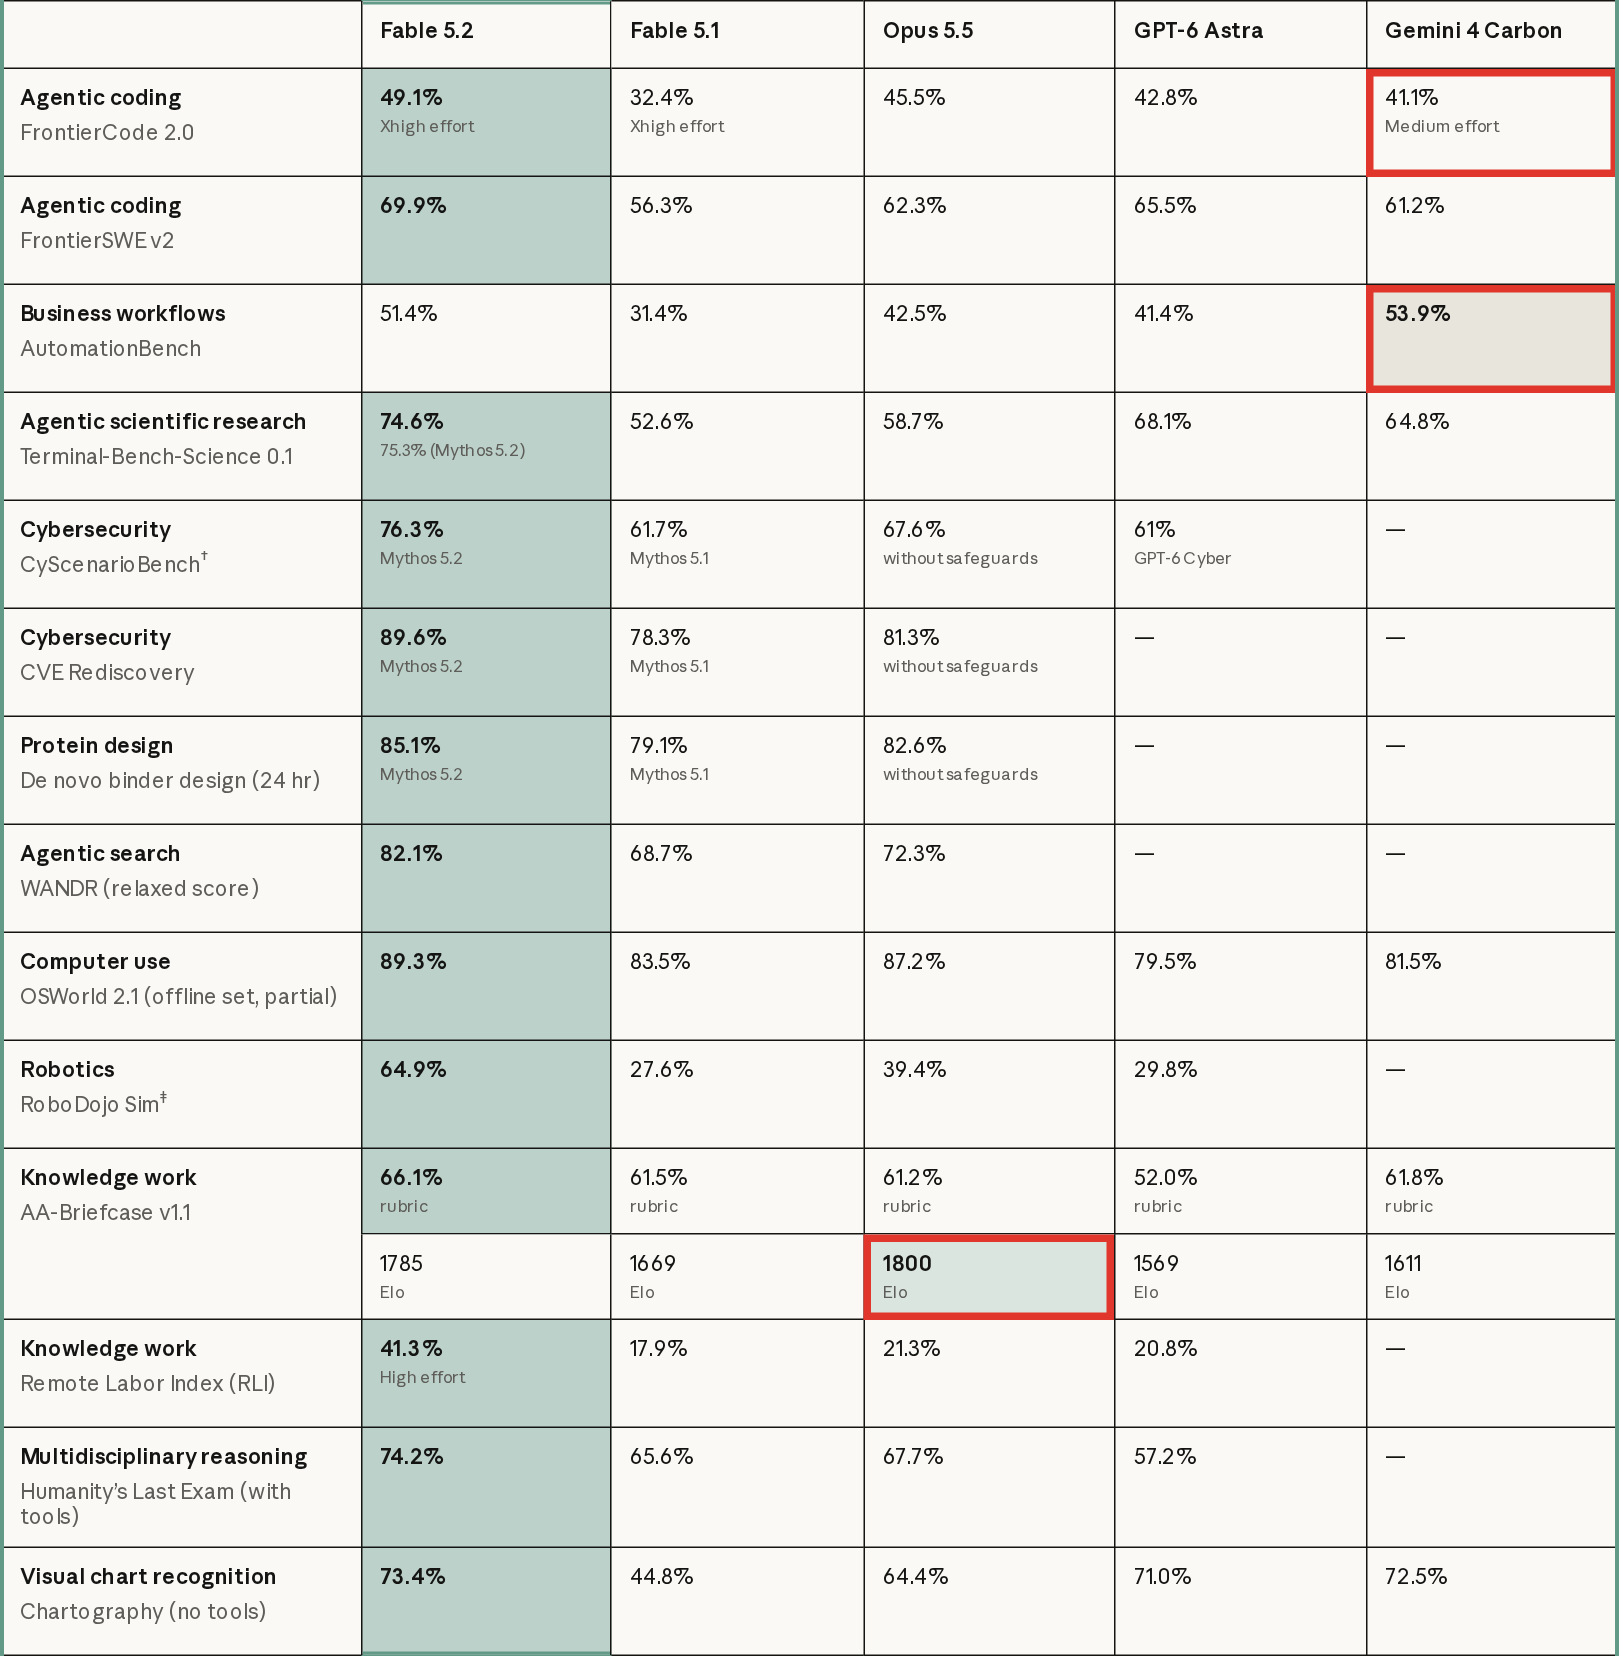
Anthropic 發表文的完整跑分表,紅框是我們標出、Fable 5.2 沒拿第一或條件不同的格子。
看這張表要一起知道的事:
- 公司日常流程(AutomationBench)第一名是 Gemini 4 Carbon,53.9% 對 Fable 5.2 的 51.4%。
- AA-Briefcase 的 Elo,Opus 5.5 的 1800 高過 Fable 5.2 的 1785。同一個測驗用 rubric 評分,Fable 5.2 的 66.1% 最高。
- FrontierCode 2.0 的比較條件不同。Fable 5.2 的 49.1% 是 Xhigh,Gemini 4 Carbon 的 41.1% 是 Medium。
- 資安和蛋白質設計那幾列是 Mythos 5.2 的成績,這篇沒放進來。Fable 5.2 的把關會擋下大部分資安任務和研究型生物學任務,用 Fable 做這兩類,很可能被轉給 Opus 回答。
發表文還寫了一句值得知道的話:Fable 5.2 和 Mythos 5.2 在測試中「懷疑自己正在被評測」的頻率,比 Anthropic 最近所有模型都高,讓他們更難判斷模型在真實環境會怎麼做。所以除了官方跑分,最好等第三方評測,也用自己的任務試過。截至台灣 11/10,我們還沒看到第三方的獨立評測,出來後會回來更新。
自己跑很久的大工程:費馬最後定理
要自己跑很久的大工程,是 Anthropic 說 Fable 最適合的工作。發表文最常被轉述的例子,是用 Lean 把費馬最後定理的證明完整形式化,也就是翻成電腦能一步一步檢查的版本。以下都是 Anthropic 自己的說法:
- 第一次做這件事的是一個未公開的研究版 Claude,花了 11 天,用專門打造的執行環境,還有研究員在旁邊指導。
- 這次是 1,000 個 Fable 5.2 agent,30 小時完成,幾乎不需要人介入。從很短的 prompt 開始,自己建立協調方式,沒有參考數學文獻,只拿到一份中間定理清單來算進度。
- 用掉的 action token 是第一次的三分之一,證明短了 7 倍。
- 同樣 1,000 個 agent 的 Opus 5.5,18 小時只完成 26%,到 30 小時幾乎沒有再前進。
圖說寫的是每個模型各跑一次,這是展示,不是統計比較。它說明的是「很多 agent 長時間協調、做一件開放的大工程」這類工作,不代表平常寫信、整理會議紀錄也會差這麼多。發表文還有兩個同類展示:一位 Anthropic 工程師讓它從空資料夾開始,協調超過 1,000 個 subagent 連續跑 8 天,做出能在筆電上開機的原型作業系統;一組跑 Fable 5.2 較早版本的 agent,把正式環境的服務從 Python 改寫成 Rust,啟動快了約 26 倍。
Anthropic 的原文建議
Fable and Mythos are best for the most ambitious, open-ended technical work. For most coding and knowledge tasks, we recommend that users start with Claude Opus 5.5, our strongest daily driver, and then switch to a different model as required.
白話講:大部分寫程式和知識工作先用 Opus 5.5,看難度再往上換 Fable,或往下換 Sonnet 5.5、Haiku 5.5。模型頁列的典型用途是跑好幾個小時的 agent、多步驟的深度研究,以及一路做到交出完成的文件、試算表或簡報的分析工作。
發表文也提到兩種搭配:讓 Haiku、Sonnet 或 Opus 遇到難題時去問 Fable 5.2(Advisor),或讓 Fable 5.2 把簡單的工作分派給小模型(Orchestrator)。
問到資安或生物,會換成 Opus 回答
Fable 5.2 和 Mythos 5.2 是同一個模型。發表文第一段就寫:「Claude Fable and Claude Mythos are the same underlying model.」Fable 多了資安和生物的安全把關,所以能開放給所有付費用戶;Mythos 只給通過 Cyber 或 Life Sciences 驗證計畫的機構。
這層把關的結果是:某些請求被擋下時,回答你的會換成另一個模型。
| 被擋的類別 | 改由哪個模型回答 |
|---|---|
| 攻擊型資安技術,例如寫 exploit、惡意程式、攻擊工具 | Opus 4.8 |
| 生物、化學、生命科學中的兩用領域,例如病毒學、毒理學、藥物設計、分子設計 | Opus 5 |
| 一小部分前沿 LLM 開發工作,例如分散式訓練基礎設施、ML 加速器設計、特定非標準晶片的 kernel 開發 | Opus 5 |
說明頁〈Why Claude switched models in your conversation with Fable models〉還寫了幾個細節:
- 換過之後,這段對話剩下的部分都停在 Opus。畫面會有提示,回覆也會標出是哪個模型回答的。要回到 Fable 得自己從模型選單切回去;原本那則請求還在對話裡的話,切回去可能又被擋,官方建議先改那則訊息再重試。
- 檢查範圍包含模型讀到的所有內容,像 memory、connector 帶進來的資料、網路搜尋結果和檔案。你上傳的一份文件也可能觸發換模型。
- 想套出模型推理過程的請求會直接被擋,不會換模型回答。
誤擋有變少:Anthropic 說,在 claude.ai、Claude Code 和 Cowork 的早期測試裡,Fable 5.2 被擋的次數比 Fable 5.1 少約 55%,資安類少約 60%,生物類少約 40%。
自動換模型的開關
第一次選 Fable 時預設是開的。要關掉:
- Claude App:Settings > Capabilities,關掉「Switch models when a message is flagged」。
- Claude Code:Config > MODEL & OUTPUT,同一個開關。
關掉之後,被擋的請求會讓對話暫停,你可以改寫訊息在同一個 Fable 模型重試,或自己丟給比較弱的模型。
API 預設不會自動換
請求被擋時,API 回傳 HTTP 200,stop_reason 是 "refusal",stop_details 會寫是哪一類政策觸發。要自動重試,可以用 server-side fallback 設 fallbacks: "default"(目前是 beta,要帶 server-side-fallback-2026-07-01 這個 beta header)、用 SDK middleware,或自己寫重試。Fable 5.2 能 fallback 的目標只有 Opus 4.8 和 Opus 5;reasoning_extraction 這一類被擋時不會重試,接手的模型也拿不到 Fable 5.2 的 thinking block。
一句話記住:Fable 和 Mythos
Fable 5.2 和 Mythos 5.2 是同一個模型,Fable 多了資安和生物的安全把關。被擋下時,資安類改由 Opus 4.8 回答,生物化學和前沿 LLM 開發類改由 Opus 5 回答,而且這段對話之後都停在 Opus。開關在 Settings > Capabilities 的 Switch models when a message is flagged。
開發者:換模型前要檢查的設定
直接把模型 ID 換掉,最可能出事的是三件事:零資料保留的組織每個請求都會回 400、rate limit 比較低、effort 預設自動高一級。完整清單在下面。
API 模型 ID 是 claude-fable-5-2(Amazon Bedrock 上是 anthropic.claude-fable-5-2),context window 1M token,單次最多輸出 128K token,知識截止 2026 年 6 月,官方寫退役時間不早於 2027 年 11 月 9 日。
從 Opus 5.5 換過來
兩者用同一套 Messages API 和工具呼叫方式,也都一直開著 adaptive thinking、不接受強制指定工具,這部分的程式碼可以直接沿用。要改的是這些:
從 Opus 5.5 換到 Fable 5.2 的檢查清單
0/10 完成從 Fable 5.1 換過來
大致上換 ID 就好,但有四個會讓程式出錯的改動:
- Prefix check 套用到所有帳號。Fable 5.1 只檢查 2026/8/31 之後建立的帳號,舊帳號在 5.1 跑得好好的程式,換到 5.2 可能開始回 400,錯誤訊息是「The block is bound to a different conversation」。
- Fable 5.1 讀不了 Fable 5.2 的 thinking block。路由、重試或 fallback 把對話從 5.2 轉到其他模型時,那些 block 會被丟掉。
- 舊的 computer use 工具
computer_20251124停用,除了 Amazon Bedrock 以外都會回 400,要改用computer_toolset_20260801。 - Advisor tool 的搭配限制:Fable 5.2 當執行者時,advisor 只能是 Fable 5.2 或 Mythos 5.2。
從更早的模型換過來會碰到的 400
- 送
thinking: {type: "disabled"},或手動設budget_tokens。Thinking 一直開著,用 effort 控制想多深。 - 帶
temperature、top_p、top_k。官方要求拿掉這三個參數,哪些數值會回 400 列在官方的 Sampling parameters 說明裡。 - 在 assistant 訊息預先填字(prefill),改用 system prompt 指示。
- 把
tool_choice設成any或指定某個工具。要拿到符合 schema 的 JSON,保留auto,搭配 strict tool use 或 JSON outputs。
thinking 的 token 也算在 max_tokens 裡。設太小的話,可能想完就用光,還沒輸出文字就以 stop_reason: "max_tokens" 結束。讀回覆要依類型挑 content block,不能直接拿 content[0].text,因為 thinking block 排在前面。
不改程式也會碰到的行為差異
- 工作還沒做完,回合就可能結束。長的多步驟任務裡,模型有時會列出剩下要做的事、問你要不要繼續,或遇到逾時這類一般障礙就停下來,low 和 medium 比較常見。
- 一長串工具呼叫中間幾乎不說話,第一次呼叫工具前也可能不先講要做什麼。
- prompt 沒講清楚程式碼歸誰時,模型傾向在既有結構上加東西,看到附近的問題會回報而不動手修。
- 會派 subagent。在 xhigh、max,官方觀察到 Fable 5.2 會自己派 subagent 檢查成果,Fable 5.1 在同樣任務不會。subagent 可能占掉一個 session 很大一部分的成本。
- 很嚴格照風格規則走。例如在 prompt 硬性限制句子長度,寫出來可能斷斷續續,舊的 system prompt 要重新檢查。
如果你的 agent 常在半路停下,官方〈Prompting Claude Fable 5.2〉提供了一段可以加進 system prompt 的文字:
Pro 的免費試用到台灣 11/17(二)15:59 結束。第三方的獨立評測出來後,我們會回來更新這篇的比較。